Google hat nicht die Ressourcen, um jede Seite im Internet auf einmal zu crawlen. Deshalb erhält jede Website ein begrenztes „Crawling-Budget“, das bestimmt, wie viele Seiten innerhalb eines bestimmten Zeitraums besucht und erfasst werden.
Stell dir deine Website als riesiges Einkaufszentrum vor. Wenn Google nur Zeit hat, sich einen Teil der Schaufenster anzusehen, bleiben die übrigen für die Kunden unsichtbar. Genau das macht das Crawl Budget – es bestimmt, welche Seiten in den Suchergebnissen erscheinen und welche keine Chance auf Sichtbarkeit bekommen.
Diese Ressource zu verstehen und gezielt zu steuern, ist der Schlüssel zu einer schnelleren Indexierung und einer stärkeren Präsenz bei Google.
Einfach gesagt: Das Crawl Budget ist der Filter, der bestimmt, wann welche Seiten sichtbar werden.
Was ist Crawl Budget?
Das Crawl Budget umfasst die gesamten Ressourcen, die Google innerhalb eines bestimmten Zeitraums für das Crawlen einer Website bereitstellt. Es gibt an, wie viele URLs gecrawlt und analysiert werden können, ohne den Server zu überlasten oder Kapazitäten für unwichtige Seiten zu verschwenden.
Beispiel: Wenn Google 2000 Seiten pro Tag crawlen kann, deine Website aber 10 000 Seiten hat, musst du sicherstellen, dass die wichtigsten Seiten innerhalb dieses Limits liegen.
Zusammengefasst: Es geht um das Gleichgewicht zwischen den technischen Möglichkeiten der Website und Googles Interesse an ihren Inhalten. Je effizienter das Crawl Budget verwaltet wird, desto schneller und vollständiger gelangen die Inhalte in den Index.
Die beiden entscheidenden Faktoren dahinter
- Crawl Rate Limit – die maximale Geschwindigkeit, mit der der Bot die Website crawlt, ohne den Server zu überlasten.
- Crawl Demand – Googles Interesse an den Inhalten.
Google Search Central erklärt: „Das Crawl Budget ist für Websites mit weniger als 1000 Seiten in der Regel kein Problem.“
Laut Ahrefs werden Websites mit einer gut strukturierten Sitemap bis zu 28% schneller indexiert.
Unterm Strich: Je größer die Website, desto wichtiger ist ein effizientes Management der Crawling-Kapazität.
Wie funktioniert die Indexierung?
Bei der Indexierung werden die Inhalte einer URL in Googles Datenbank gespeichert. Nur Ressourcen, die im Index enthalten sind, können in den Suchergebnissen erscheinen.
Die Schritte sind einfach: Der Googlebot besucht die URL, die Algorithmen analysieren Inhalte und Links, und es wird entschieden, ob die Seite einzigartig, nützlich und zugänglich ist.
HubSpot weist darauf hin, dass über 61% der SEO-Fachleute die Indexierungsgeschwindigkeit zu ihren wichtigsten Prioritäten zählen.
Einfach gesagt: Eine schnelle Indexierung ist das Ergebnis gezielt eingesetzter Crawling-Ressourcen.
Warum ist Crawling so wichtig?
Crawling ist der erste Schritt vor der Aufnahme in den Index. Wenn der Googlebot eine Ressource nicht crawlt, hat sie keine Chance, in den Suchergebnissen zu erscheinen.
Beispiele, bei denen Crawling entscheidend ist:
- Nachrichtenwebsites – wenn die Algorithmen eine Nachricht nicht rechtzeitig erfassen, verliert sie an Wert.
- Onlineshops – neue Produkte müssen schnell indexiert werden, um Kunden zu erreichen.
Semrush belegt, dass Websites mit optimierter Ladegeschwindigkeit im Durchschnitt 23% mehr Crawls pro Monat erhalten.
Zusammengefasst: Ohne Crawling gibt es keine Indexierung und keine Sichtbarkeit.
Warum ist das Crawl Budget wichtig?
Es ist eine begrenzte Ressource, die strategisch gesteuert werden muss. Werden die Kapazitäten für doppelte oder nutzlose URLs verbraucht, bleiben wertvolle Seiten außen vor.
Instrumente zur Steuerung
- Sitemap.xml – weist auf die wichtigsten Seiten hin.
- Robots.txt – blockiert unnötige und automatisch generierte URLs.
Beispiel: Ein Onlineshop mit Filtern für Größe, Marke und Farbe kann Hunderttausende unnötige URLs erzeugen, die Crawling-Kapazität aufbrauchen.
Einfach gesagt: Die richtige Verteilung der Crawling-Ressourcen gewährleistet eine schnellere Indexierung wichtiger Bereiche.
Wie überprüfe ich mein Crawl Budget?
Jede Website hat eine andere Crawling-Kapazität. Die tatsächlichen Daten findest du in der Google Search Console → Crawling-Statistiken.
Orientierungswerte
- Kleine Websites – einige Hundert Anfragen pro Monat reichen aus.
- Große Websites – Tausende Crawls pro Tag für eine aktuelle Indexierung.
Zusammengefasst: Behalte die Berichte in der Search Console im Blick und prüfe, ob der Bot Zeit mit zweitrangigen Ressourcen verschwendet.
Wie optimiere ich das Crawl Budget?
Optimierung bedeutet, die Algorithmen auf wertvolle Ressourcen zu lenken und Verluste zu minimieren.
Checkliste zur Optimierung
- Erstelle eine aktuelle sitemap.xml mit den wichtigsten Seiten.
- Konfiguriere die robots.txt so, dass doppelte URLs und Filter blockiert werden.
- Baue eine starke interne Verlinkungsstruktur auf.
- Behebe 404-Fehler und entferne unnötige Weiterleitungen.
- Verbessere die Ladegeschwindigkeit durch die Optimierung von Bildern und Hosting.
Backlinko zeigt, dass Websites mit einer klaren internen Struktur eine 36% schnellere Indexierung erreichen.
Einfach gesagt: Jeder Schritt der technischen Optimierung erhöht die Crawling-Effizienz.
Welche Fehler verbrauchen unnötig Crawling-Kapazität?
Häufige Probleme sind:
- Duplicate Content.
- Automatisch generierte Parameter.
- Endlose Filterkombinationen.
- Ein langsamer Server.
- Eine fehlende sitemap.xml.
Beispiel: Bei einem Nachrichtenportal mit Datumsarchiven können sich Tausende Seiten ohne Traffic ansammeln.
Zusammengefasst: Entferne Duplikate und unnötige URLs, um Ressourcen für wertvolle Bereiche freizusetzen.
Wann ist das Crawl Budget kein Problem?
Bei kleinen Websites mit weniger als 500 URLs sind die Ressourcen fast nie ein Problem – der Bot kann alles in einem Durchgang crawlen.
Die eigentliche Herausforderung entsteht bei großen Projekten mit Tausenden Seiten und dynamischen Inhalten. Dort ist eine Strategie zur Steuerung unverzichtbar.
Einfach gesagt: Bei kleinen Websites besteht kein Grund zur Sorge, große Websites benötigen dagegen regelmäßige Optimierung.
Welche Rolle spielen interne Links?
Interne Links zeigen den Algorithmen, welche Bereiche Priorität haben.
Grundprinzipien:
- Mehr Links auf eine Ressource = häufigeres Crawling.
- Orphan Pages (Seiten ohne eingehende Links) werden häufig nicht gecrawlt.
Zusammengefasst: Interne Links sind Googles Wegweiser durch deine Website.
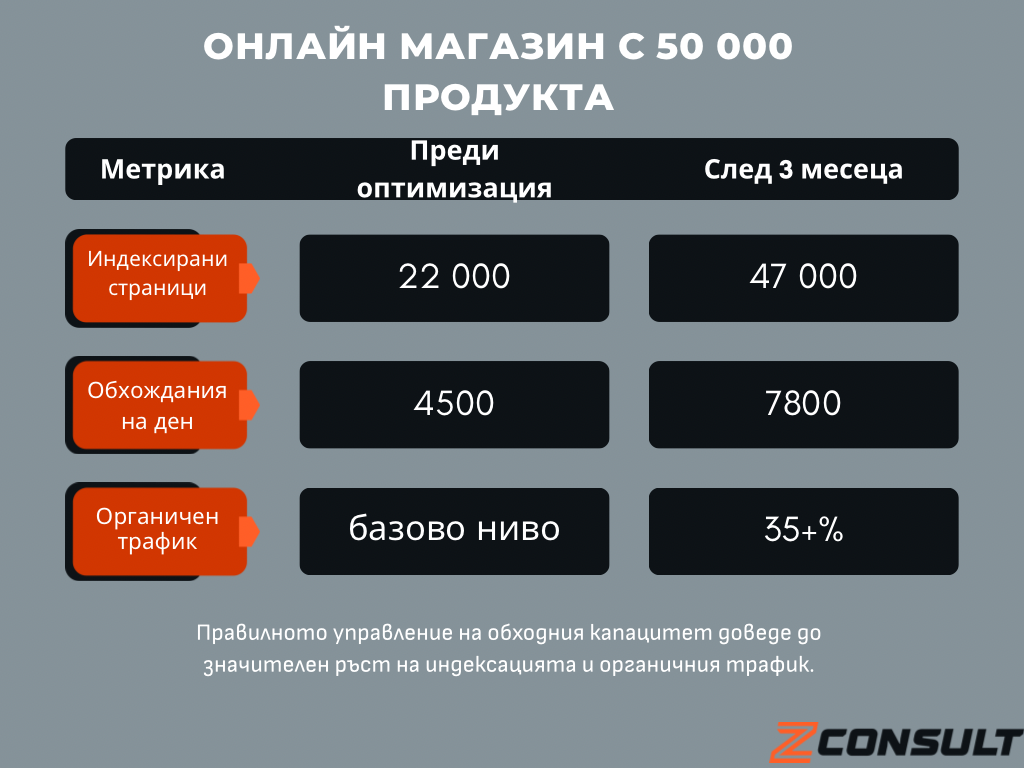
Case Study: Onlineshop mit 50 000 Produkten
Problem:
Ein großer Onlineshop hatte 50 000 Produkte, aber nur 22 000 davon waren im Index enthalten.
Analyse:
Google verbrauchte Ressourcen für Filter und Parameter, durch die über 200 000 überflüssige URLs entstanden.
Lösung
- Blockierung der Filter in der robots.txt
- Neue Sitemap mit priorisierten Produkten
- Entfernung doppelter URLs
- Optimierung der Ladegeschwindigkeit
Ergebnis
Tools zur Steuerung
- Google Search Console – zeigt die tatsächlichen Crawling-Daten.
- Screaming Frog – erkennt Duplikate und technische Fehler.
- Ahrefs und Semrush – Analyse der Indexierung und von Crawling-Problemen.
- Sitebulb – umfassende technische Audits.
Einfach gesagt: Die Kombination aus GSC und professionellen Tools ist für große Websites unverzichtbar.
FAQ – Häufig gestellte Fragen
- Wie erkenne ich, ob Google wichtige Ressourcen übersieht?
Prüfe in der Search Console die Anzahl der indexierten URLs und vergleiche sie mit dem tatsächlichen Umfang deiner Inhalte. - Wie oft crawlt Google Websites?
Beliebte Websites – täglich, kleinere – mehrmals pro Woche oder Monat. - Beeinflusst die Ladegeschwindigkeit die Crawling-Kapazität?
Ja. Je schneller die Website lädt, desto mehr Ressourcen werden gecrawlt. - Was ist wichtiger – sitemap.xml oder robots.txt?
Beides. Die Sitemap verweist auf die wichtigsten Seiten, die robots.txt blockiert unnötige Seiten. - Wie beschleunige ich die Indexierung neuer Inhalte?
Nimm sie in die Sitemap auf, setze interne Links und nutze die URL-Prüfung in der Search Console. - Spielt das Hosting eine Rolle?
Ja. Stabiles und schnelles Hosting erhöht die Geschwindigkeit und ermöglicht mehr Crawls. - Was ist Crawl Demand?
Das ist das Interesse der Algorithmen an der Website – je beliebter und aktueller sie ist, desto mehr Aufmerksamkeit erhält sie. - Kann ich die Crawling-Ressourcen künstlich erhöhen?
Nicht direkt. Durch eine optimierte Struktur und regelmäßig aktualisierte Inhalte gibst du Google aber einen Anreiz. - Wie oft sollte ich das Crawl Budget optimieren?
Große Websites – mindestens einmal pro Quartal ein Audit. Kleine Websites – bei wesentlichen Änderungen. - Was ist der Unterschied zwischen Crawl Budget und Indexation Budget?
Das Crawl Budget bezeichnet die Anzahl der URLs, die gecrawlt werden können. Das Indexation Budget bezeichnet die Anzahl der Ressourcen, die in den Index aufgenommen werden.
Optimiere dein Crawl Budget noch heute
Das Crawl Budget ist eine begrenzte Ressource, die bestimmt, welche Seiten gecrawlt werden und wann sie indexiert werden. Bei kleinen Websites ist das Problem gering, für große Onlineshops und Medienwebsites ist die Steuerung jedoch entscheidend.
Die richtige Konfiguration von sitemap.xml, robots.txt, internen Links und Ladegeschwindigkeit gewährleistet, dass Google seine Kapazitäten für Inhalte mit echtem Mehrwert einsetzt.
Starte noch heute – überprüfe dein Crawl Budget in der Google Search Console, identifiziere Schwachstellen und setze Optimierungen um. Jeder Tag Verzögerung bedeutet verlorenen potenziellen Traffic.
Autor
Yordan Mirchev
BEO-Spezialistin
Yordan ist Teil des BEO/SEO-Teams. Er beschäftigt sich mit Analyse, Inhalten und Optimierung auf Basis der tatsächlichen geschäftlichen Anforderungen.
Autorenprofil